В прошлой статье про маппинг я показывал, как через Python-маппинг передать из верхнеуровневых сущностей параметры в элементы которые располагаются ниже и являются их детьми. Например, получить тип прокладки, отметку или тип системы и записать их в нужные параметры IFC.
Теперь давайте поднимемся ещё на один уровень и заберём информацию с самой модели из Атрибутов
В Robur у моделей есть окно «Атрибуты» с вкладками «Штамп» и «Пользовательские».
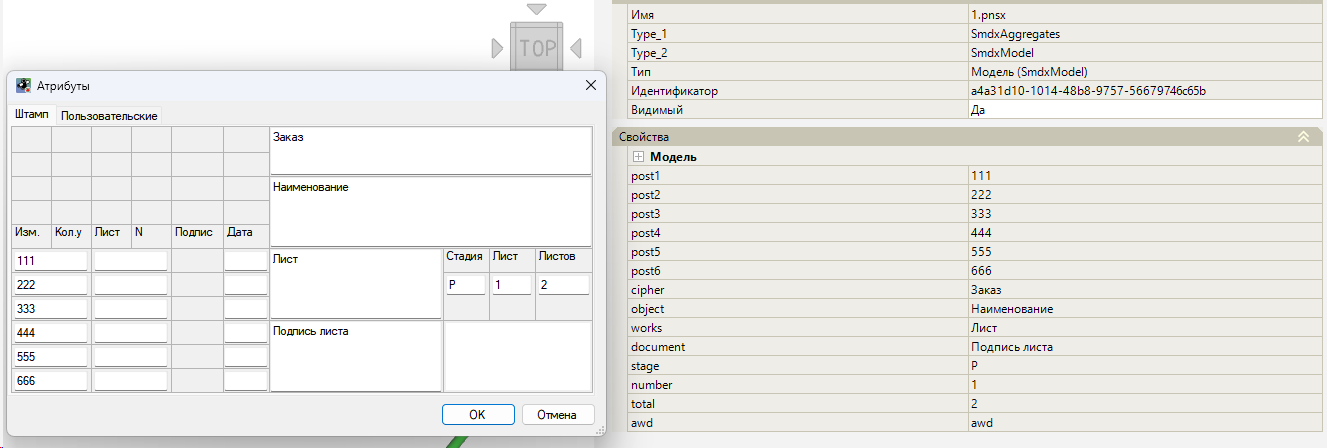
В нём можно заполнить общие данные: код объекта, раздел, ответственного или любой свой параметр. Задача - передать эти значения во вложенные элементы при экспорте, чтобы не заполнять одну и ту же информацию.
Сначала определимся с задачей
Давайте представим обычную ситуацию. У нас есть модель наружных инженерных сетей, и во все её элементы надо передать код объекта и фамилию ответственного. Данные общие для всей модели, но в IFC они должны находиться внутри каждого нужного элемента.
В своей работе я придерживаюсь одной логики: если информация уже есть в программе, она должна приходить оттуда. Заполнили значение один раз, настроили правило передачи и дальше используем его при выгрузке.
Для этого не нужно создавать копии библиотечных элементов под каждый объект или заполнять общие свойства по одному. Мы добавим в стандартный Python-маппинг две небольшие функции, а правила передачи напишем через уже знакомые `filter` и `flush`
Заполняем атрибуты именно модели
В структуре проекта выберите нужную модель (или свойства папки- Атрибуты, свойства из папки перейдут во вложенные модели), откройте «Атрибуты» → «Пользовательские» и добавьте, например, такие параметры:
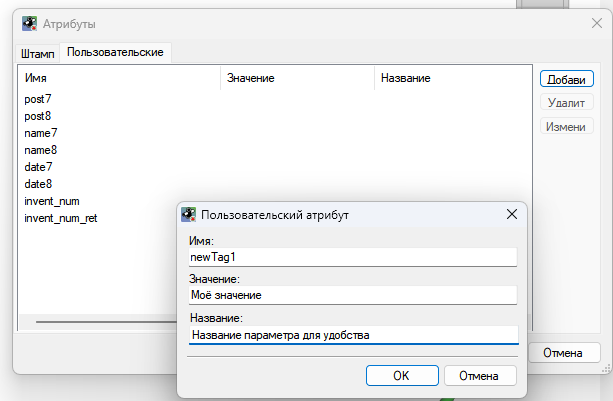
Здесь важно разделять две колонки.
«Имя» - это имя, по которому мы будем получать свойство в маппинге.
«Название» - его отображаемая подпись.
Если в колонке «Имя» указано newTag1, в коде тоже пишем newTag1, сохраняя регистр.
В этих атрибутах мы работаем с обычными строковыми значениями. Функция просто получит строку и передаст её дальше.
Аналогично можно использовать атрибуты штампа: нужно знать их действительное имя. Для начала удобнее проверить подход на одном собственном параметре, имя которого вы задали сами.
Открываем Python-файл маппинга
Для Robur Pipes 16.0 стандартные маппинги находятся в каталоге:
C:\ProgramData\Topomatic\Robur Pipes\16.0\Support\ifc
В другом модуле или версии Robur путь будет соответствовать установленному продукту.
Будем работать с копией маппинга в своей папке. Если используется пара `.py` и `.xml`, скопируйте оба файла. При переименовании у них должна оставаться одинаковая основа имени, например `MyMapping.py` и `MyMapping.xml`.
Примеры ниже рассчитаны на стандартный шаблон маппинга с функциями `get_property`, `filter`, `flush` и `process_custom`, который мы создавали с вами в прошлый раз.
Добавляем две функции для чтения модели
Найдите в `.py` функцию `def process_custom(group):`. Перед ней, вне других функций, вставьте следующий блок
def find_model(group):
	current = group
	while current is not None:
		object_type = current.GetObjectType()
		if object_type is not None and object_type.IsAssignableTo("SmdxModel"):
			return current
		current = current.Parent
	return None

def get_from_model(group, tag):
	model = find_model(group)
	if model is None:
		return None
	prop = get_property(model, tag)
	return prop.Value if prop is not None else None
Рассказываю, что здесь происходит.
find_model поднимается от текущего элемента по его родителям и находит ближайший узел модели. Мы ищем модель по типу SmdxModel, включая производные типы, а не по наличию нужного параметра.
Почему это важно? Одноимённое свойство может быть и у элемента, и у сегмента. Нам нужно значение именно модели, поэтому сначала находим модель, а уже потом читаем её атрибут.
get_from_model получает свойство по имени и возвращает его значение как есть. Если модель или свойство не найдены, функция возвращает None, и стандартная flush не добавляет эту строку свойств.
Например, вызов:
get_from_model(group, "newTag1")
вернёт Моё значение, если такое значение записано в атрибуте newTag1 модели текущего элемента.
В сводной SDMX-модели это тоже имеет значение: элементы каждой исходной модели будут получать данные из своего ближайшего узла модели
Описываем, какие параметры передавать
Сразу после этих двух функций, но всё ещё перед process_custom, добавим правила:
def process_model_attributes(group):
	model = find_model(group)
	if model is None or model == group:
		return


	if filter(group, "$name*"):
		flush(group, [
			# IFC-атрибут                 # функция-источника     # имя атрибута модели
			["Экспертиза|Код объекта",  get_from_model(group, "newTag1")],
			["Экспертиза|Раздел",  get_from_model(group, "SectionCode")],
			["Экспертиза|Ответственный",  get_from_model(group, "Responsible")],
		])
Разбираем строку:
["Экспертиза|Код объекта", get_from_model(group, "newTag1")],
Экспертиза|Код объекта - имя будущего свойства в IFC. До вертикальной черты указан набор свойств, после неё — название параметра внутри этого набора.
get_from_model(group, "newTag1") - источник значения. Берём строку из атрибута newTag1 своей модели.
В результате внутри подходящего элемента появится набор Экспертиза, а в нём параметр Код объекта со значением Моё значение.
Фильтр $name* проверяет наличие имени. Это широкий фильтр: под него могут попасть не только отдельные физические элементы, но и именованные группы. Начальная проверка в функции пропускает сам узел модели и объекты вне модели. Если нужны только определённые виды элементов, дальше покажу, как сузить правило.
Подключаем правила к обработке
Теперь находим существующую функцию process_custom и добавляем в её начало один вызов:
def process_custom(group):
	process_model_attributes(group)
	return False
Так будет выглядеть функция, если до этого она была пустой.
Если в ней уже есть ваши условия для труб, кабелей, отметок или других параметров, сохраняйте их. Добавьте только строку process_model_attributes(group) в начало, перед этими условиями.
Не создавайте вторую функцию с тем же именем. Новое определение process_custom заменит прежнее, и старые правила перестанут вызываться.
return False оставляем: в этом стандартном шаблоне после пользовательской обработки выполнятся также правила из соседнего XML-файла.
А если разным элементам нужны разные значения?
Здесь мы используем вашу обычную систему фильтрации. Например, в одной модели есть трубы и кабели. Для них нужно заполнить одинаковый IFC-параметр «Код», но взять разные строки из атрибутов модели.
- Имя PipeCode и CableCode
- Значения соответсвующие К1 и ЭС
Заменяем предыдущую функцию process_model_attributes на этот вариант:
def process_model_attributes(group):
	model = find_model(group)
	if model is None or model == group:
		return


	if filter(group, "$type_4 = SmdxNetworksPipe"):
		flush(group, [
			# IFC-атрибут                 # функция-источника     # имя атрибута модели
			["Экспертиза|Код",  get_from_model(group, "PipeCode")],
		])


	if filter(group, "$type_4 = SmdxNetworksWire"):
		flush(group, [
			# IFC-атрибут                 # функция-источника     # имя атрибута модели
			["Экспертиза|Код",  get_from_model(group, "CableCode")],
		])
Что получаем: у труб «Экспертиза - Код» будет равен К1, у кабелей - ЭС. Оба значения хранятся на модели, но каждому виду элементов передаётся своя строка.
Это примеры фильтров для инженерных сетей. Для своих элементов используйте их реальные Smdx-типы и привычные запросы из вашего маппинга. Число в $type_4 относится к уровню типа, поэтому для другого типа нельзя механически менять только его название.
В каждом flush можно передавать несколько параметров. Можно также сочетать общий блок для всех элементов и отдельные блоки для определённых видов.
Следите только за повторной записью одного свойства. Если элемент подходит под несколько условий и они записывают одно и то же `Набор|Свойство`, более поздняя запись может заменить предыдущую. Это относится и к последующим правилам XML.
Что будет, если такой же параметр задан на папке?
Атрибуты могут быть заполнены и на папках проекта. При создании SDMX Robur разрешает наследование: если на модели задано собственное значение того же имени, оно имеет приоритет.
Наш код читает итоговый параметр из узла модели. Он не ищет запасное значение в папке, сегменте или самом элементе.
Но здесь есть один нюанс: если значение папки уже унаследовано и записано в узел модели, обычный маппинг не узнает, где его ввели первоначально. Поэтому, когда нужен определённый код для конкретной модели, задавайте его непосредственно на ней.
Итоги
Так у нас появляется ещё один способ организовать передачу информации из Robur: общие данные заполняем на модели, а через маппинг распределяем их по нужным элементам. Дальше можно использовать ту же логику для кодов объектов, разделов, ответственных и других строковых параметров, которые должны сопровождать элементы в IFC.